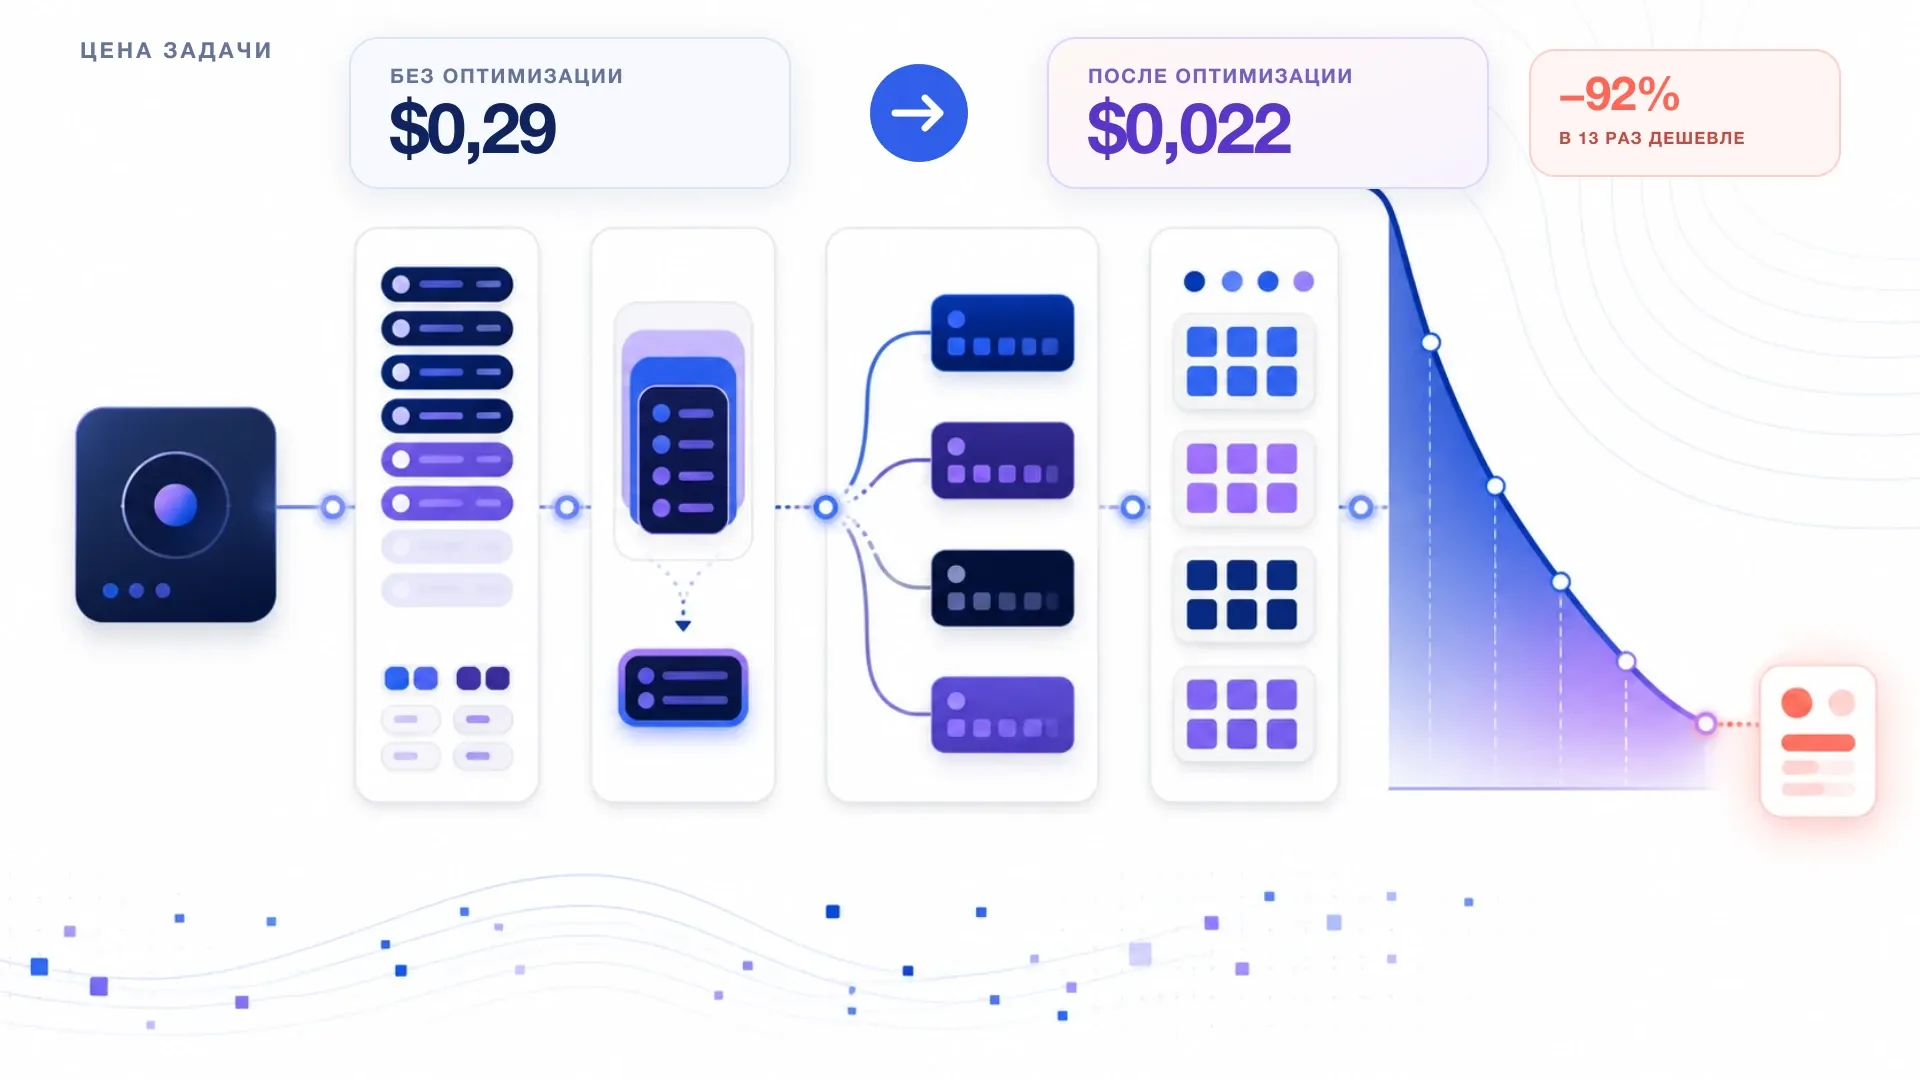
У Anthropic есть практическое руководство по снижению расходов, которое команда прикладного ИИ использует в работе с клиентами. В нём затраты показывают не через общие советы, а на одном измеримом примере: ИИ-агент разбирает страховые заявления, для десяти задач заранее известны правильные ответы, а каждый способ экономии измеряется до и после изменения.
Ниже — основные выводы, цифры и важные оговорки из этого эксперимента.
Исходная точка: $0,29 за задачу
Агент работает оценщиком в условной страховой компании Acme Insurance. В его системной инструкции около 12 тысяч токенов правил андеррайтинга, восемь инструментов для проверки заявления, полиса, истории, риска мошенничества, ущерба, фотографий, выплаты и документов. Возможны четыре решения: одобрить, отклонить, передать руководителю или направить на дополнительную проверку.
Модель Opus с высоким уровнем рассуждения решает все 10 задач правильно: 36 обращений к модели, $0,2906 за задачу и $2,91 за весь прогон. При миллионе заявлений в год каждый сэкономленный цент означает примерно $10 000 экономии.
Из этого примера следуют два главных правила.
Правило 1. Считайте стоимость задачи, а не токена
Цена миллиона токенов сама по себе мало о чём говорит. Более дорогая модель может оказаться выгоднее, если она делает меньше шагов и реже ошибается. Поэтому нужно складывать входные и выходные токены, чтение и запись кэша по всем обращениям одной задачи, а затем делить общую стоимость на число задач.
Каждую конфигурацию авторы запускают минимум дважды и одновременно смотрят на стоимость и долю правильных ответов. Один прогон может случайно оказаться удачным или неудачным.
Правило 2. Качество — это ограничение
Сначала агент должен стабильно решать задачу на сильной модели. Затем создаётся проверочный набор, снимаются исходные показатели и только после этого начинаются эксперименты. В примере проверочный набор состоит из десяти заявлений с человеческой разметкой, а проходной результат равен 10 из 10.
Конфигурация с результатом 9 из 10 не считается оптимизацией, даже если она дешевле. Без проверочного набора экономию невозможно отличить от незаметного ухудшения продукта.
В каком порядке сокращать расходы
Anthropic предлагает двигаться так:
- Кэширование повторяющейся части запроса.
- Сокращение входных данных и поэтапная загрузка контекста.
- Очистка и сжатие истории, вынос отдельных задач в подагенты.
- Ограничение выходных данных.
- Пакетная обработка.
- Снижение уровня рассуждения и переход на более дешёвую модель.
Выбор более дешёвой модели стоит последним, потому что только он напрямую снижает интеллектуальный запас системы. Предыдущие шаги убирают расходы, которые сами по себе не повышали качество.
Кэширование: до 54% экономии
При кэшировании постоянной части запроса первое обращение записывает 13 097 токенов, а следующие читают их за десятую часть цены. На двух дополнительных запросах по одному заявлению стоимость снижается с $0,1347 до $0,0910 — на 32%. Для этого достаточно правильно расставить cache_control.
Кэш легко разрушить мелочами. Текущая временная метка внутри системной инструкции меняет её при каждом запросе и поднимает стоимость до $0,1712. Если оставить системную часть неизменной, а время перенести в сообщение пользователя, стоимость падает до $0,0966 — на 44%.
Важен и порядок блоков. Если данные конкретного заявления поставить перед общей инструкцией, кэш приходится переписывать на каждой задаче: $0,2784 за три заявления. Если инструкция идёт первой, а граница кэша стоит после неё, получается $0,1273 — на 54% меньше.
Практическое правило простое: постоянная часть запроса должна совпадать байт в байт, переменные данные должны идти после неё, а модель и история не должны без необходимости меняться между шагами.
Входные данные: не кладите весь справочник в контекст
Инструкцию объёмом около 11 тысяч токенов можно убрать из системного сообщения и дать агенту инструмент read_manual. Тогда постоянная часть запроса сокращается с 13 462 до 2 517 токенов. Удаление повторов в описаниях инструментов экономит ещё 392 токена, а отложенная загрузка через поиск инструментов (defer_loading) уменьшает объём до 1 696. Изображения заранее приводят к 1280×720: около 1 200 токенов на фотографию вместо 4 000.
Особенно показателен справочник на 5 000 строк, который занимал около 135 тысяч токенов:
- передать всю таблицу в контекст — $0,6824;
- загрузить файл через Files API и обработать его инструментом
code_execution— $0,1436.
Экономия составляет 79%. При этом модель перестаёт пересказывать таблицу и начинает вычислять ответ.
Есть и обратная сторона: короткая системная инструкция иногда увеличивает число шагов, потому что нужные сведения приходится запрашивать инструментами. Поэтому поэтапную загрузку контекста тоже нужно проверять на своих задачах.
Длинная история: 135 тысяч токенов не обязаны оставаться навсегда
В нагрузочном примере агент разбирает три заявления подряд, а на втором шаге получает справочник на 135 тысяч токенов. Общий контекст разрастается до 154 510 токенов.
| Подход | Стоимость прогона | Экономия |
|---|---|---|
| Без управления историей, с кэшем | $1,7945 | — |
Очистка результатов инструментов (clear_tool_uses) |
$1,5722 | 12% |
Сжатие истории (compact_20260112) |
$1,5114 | 16% |
| Очистка на границах заявлений | $1,2820 | 29% |
| Основной агент и отдельный подагент | $0,3978 | 78% |
Очистка контекста одним шагом убрала 135 051 токен. В варианте с подагентом дешёвая модель Haiku обрабатывает справочник целиком, а основной агент получает короткую выжимку и никогда не держит в истории больше примерно 18 тысяч токенов.
Но очистка истории сбрасывает кэш после изменённого места, поэтому её лучше запускать редко и при достаточно большом объёме. У подагента собственная постоянная часть запроса; кэш с основным агентом не общий.
Выходные данные: 61 токен вместо 4 096
Выходные токены обычно заметно дороже входных, а без чётких рамок модель склонна объяснять слишком много. При одинаковом ограничении max_tokens=4096 получились такие результаты:
- свободная форма ответа: 4 096 токенов и $0,1585;
- строгий шаблон
DECISION: <...> | AMOUNT: $<n> | REASON: <20 слов>: 61 токен и $0,0580.
Экономия — 63%, а ответ становится проще разбирать программно.
Для ошибочного входа полезна стоп-последовательность. Без неё модель написала 2 890 токенов объяснений за $0,1281. С маркером <CANNOT_REVIEW> ответ занял 13 токенов и стоил $0,0564 — на 56% меньше.
max_tokens здесь служит не способом настройки модели, а предохранителем: его ставят немного выше максимально допустимого полезного ответа.
Пакетный API: вдвое дешевле, если ответ не срочный
Десять одинаковых запросов на сортировку заявлений стоили $0,7379 при обычной отправке и $0,3653 через Batch API. Качество не изменилось, а кэширование продолжило работать вместе с пакетной скидкой.
Ограничение в том, что пакетная обработка рассчитана на отдельные запросы. Полный агентный цикл с последовательными вызовами инструментов внутри пакета не выполняется. Указанные 24 часа — срок, после которого пакет истекает, а не обещанное время ответа.
Модель и уровень рассуждения
После остальных улучшений можно постепенно снижать уровень рассуждения и переходить на более дешёвые модели. Каждую конфигурацию проверяли дважды, проходной результат оставался равен 10 из 10.
| Конфигурация | Результат двух прогонов | Стоимость задачи |
|---|---|---|
| Opus, высокий уровень, без кэша | 10/10 | $0,2906 |
| Opus, высокий уровень, с кэшем | 10/10 и 10/10 | около $0,150 |
| Opus, средний уровень | 10/10 и 10/10 | около $0,137 |
| Opus, низкий уровень | 10/10 и 10/10 | около $0,121 |
| Sonnet, высокий уровень | 10/10 и 10/10 | около $0,054 |
| Sonnet, средний уровень | 10/10 и 10/10 | около $0,050 |
| Sonnet, низкий уровень | 9/10 и 8/10 | около $0,050 |
| Haiku | 7/10 и 4/10 | около $0,019 |
Sonnet со средним уровнем рассуждения сохраняет 10 из 10 при цене примерно в 5,9 раза ниже исходной. При этом переход с Opus на Sonnet даёт около трёхкратной экономии относительно Opus с уже включённым кэшем; остальная разница достигается именно кэшированием.
Haiku оказался слишком слаб для этой задачи: 55% правильных ответов. Дешёвый, но иногда неверный результат — не оптимизация.
Схема с «советником», где дешёвая модель при необходимости обращается к Opus, помогает только тогда, когда есть надёжный и дешёвый признак сложной задачи. В эксперименте основная модель не замечала часть пограничных случаев и не просила помощи.
Другой вариант — пять подагентов Haiku и итоговое решение Sonnet — дал 9 из 10 при $0,0188 за задачу. Единственная ошибка возникла потому, что сокращённая карточка правил потеряла важное исключение из исключения. Это хорошая иллюстрация цены чрезмерного упрощения.
Итоговые цифры
| Конфигурация | Стоимость задачи | Удешевление | Результат |
|---|---|---|---|
| Исходный Opus, высокий уровень | $0,29 | — | 10/10 |
| Все безопасные способы вместе | $0,022 | в 13 раз | 10/10 |
| Подагенты Haiku и решение Sonnet | $0,019 | в 15 раз | 9/10 |
| Пакетная одиночная обработка | $0,006 | в 48 раз | 9/10 |
Главный результат — 13-кратное снижение стоимости без потери качества. Дальнейшая экономия уже покупается ценой одной ошибки на десять задач. Где проходит допустимая граница, должен решать ваш проверочный набор, а не чужой пример.
Как подобрать способ экономии
| Что происходит | Что попробовать |
|---|---|
| Большая неизменная инструкция и описания инструментов | Кэширование постоянной части запроса |
| Большие справочники, которые нужны лишь иногда | Инструмент чтения, поиск инструментов, Files API и выполнение кода |
| В истории копятся громоздкие промежуточные результаты | Редкая очистка или сжатие истории |
| Есть независимые тяжёлые подзадачи | Дешёвые подагенты и сильный основной агент |
| Ответы слишком многословны | Строгий шаблон и стоп-последовательность |
| Ответ не нужен немедленно | Пакетный API со скидкой 50% |
| Простые и сложные задачи перемешаны | Сначала снизить уровень рассуждения, затем сменить модель или добавить маршрутизацию |
Что делать на практике
Метод переносится на любую агентную систему. Соберите хотя бы десять типовых задач с правильными ответами, измерьте стоимость задачи на сильной конфигурации, а затем по одному применяйте способы из списка. Принимайте только изменения, которые не ухудшают результат на проверочном наборе.
Удобно, когда для такого сравнения не нужен отдельный аккаунт у каждого поставщика. Через Omni Router модели Claude, GPT и Kimi доступны по единому API с оплатой фактического использования. Одну задачу можно прогнать на разных моделях и сравнить реальную стоимость, а не только цены из таблицы.
